モデルが自分の PC で有多大になるかを決めるのは、VRAM とシステム RAM の合計ひとつです。Maya はよく使う部分を GPU に、残りを RAM に置き、収まらない部分は回答中に高速な NVMe SSD から読み出します。
二つの数値を分けて考えます。*モデル全体*はモデル全体を VRAM と RAM に常駐させるのに必要な容量、*推奨値*は OS と既定のコンテキスト分を加えた値です。推奨値を下回っても動くのは、足りない分が SSD からストリームされるからです。
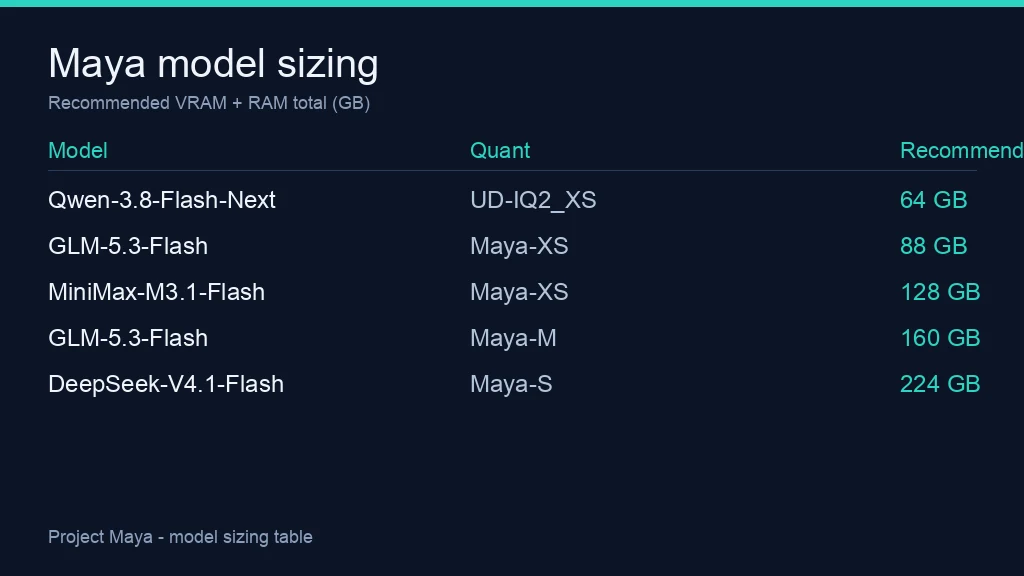
VRAM + RAM の早見表
単位は GB。「モデル全体」は全部をメモリに置くために必要な容量、「推奨値」はシステムと既定コンテキスト込みです。
| モデル | Quant | モデル全体 | 推奨値(VRAM + RAM) | 動作環境 |
|---|---|---|---|---|
| GLM-5.3-Flash | Maya-XS | 約 80 | 88 | NVIDIA、AMD、Mac* |
| GLM-5.3-Flash | Maya-S24 | 約 102 | 128 | NVIDIA、AMD、Mac* |
| GLM-5.3-Flash | Maya-S(既定) | 約 104 | 128 | NVIDIA、AMD、Mac* |
| GLM-5.3-Flash | Maya-M | 約 124 | 160 | NVIDIA、AMD、Mac* |
| GLM-5.3-Flash | Maya-L | 約 164 | 192 | NVIDIA、AMD、Mac* |
| DeepSeek-V4.1-Flash | Maya-XS | 121 | 128 | NVIDIA、AMD |
| DeepSeek-V4.1-Flash | Maya-S(既定) | 186 | 224 | NVIDIA、AMD |
| DeepSeek-V4.1-Flash | UD-IQ1_M | 140 | 160 | NVIDIA、AMD |
| MiniMax-M3.1-Flash | Maya-XS | 100 | 128 | NVIDIA、AMD |
| MiniMax-M3.1-Flash | Maya-S | 130 | 160 | NVIDIA、AMD |
| Qwen-3.8-Flash-Next | UD-IQ2_XS | 47 | 64 | NVIDIA、AMD |
| Qwen-3.8-Flash-Next | CYBER-FROST Q5_K_M | 84 | 96 | NVIDIA、AMD |
\* Mac(Apple Silicon)対応は実験的で、GLM-5.3-Flash の GGUF quant のみです。DeepSeek と Qwen に含まれる n-gram テーブルは SSD に残り続けてメモリには数えないため、ダウンロード容量は表の数値より大きくなります。
手元のマシンに合わせる
| 手元の PC | 合計 | 完全に収まる | 動くが遅いもの |
|---|---|---|---|
| 16 GB GPU + 48 GB RAM | 64 | Qwen UD-IQ2_XS | GLM Maya-XS、GLM Maya-S24 |
| 24 GB GPU + 64 GB RAM | 88 | GLM Maya-XS、Qwen UD-IQ2_XS | GLM Maya-S24、Qwen CYBER-FROST |
| 32 GB GPU + 96 GB RAM | 128 | GLM Maya-S、GLM Maya-S24、MiniMax Maya-XS | GLM Maya-M |
| 48 GB GPU + 128 GB RAM | 176 | GLM Maya-M、MiniMax Maya-S | GLM Maya-L、DeepSeek Maya-S |
| 64 GB GPU + 128 GB RAM | 192 | GLM Maya-L | DeepSeek Maya-S |
| 64 GB GPU + 192 GB RAM | 256 以上 | DeepSeek Maya-S、MiniMax EXL3 | DeepSeek UD-IQ3_S |
| 384 GB RAM のサーバー | 384 以上 | すべてのモデル(DeepSeek UD-Q8_K_XL を含む) | — |
Strix Halo、Gorgon Halo、Mac のような共有メモリのマシンでは合計を一度だけ数え、OS 用に約 16 GB を残します。独立显卡では配分がより重要です。同じ合計でも、VRAM 側の割合が多いほど速くなります。
底线
対応 GPU、32 GB の RAM、そしてダウンロードに十分な高速 NVMe SSD があれば、推奨値を下回ってもすべてのモデルが動きます。ハードディスクは代用になりません。
VRAM + RAM に入らない部分は回答中に SSD から読み込まれます。動作はしますが、推奨値から離れるほど遅くなります。セットアップがこの PC でどれだけのモデルをメモリに常駐できるかを表示してくれるため、数百 GB のダウンロードを決める前に数字を確認できます。
表の小さい側では、「大きめのモデルを 1 つ動かす」定番構成は RTX 4090 か RX 7900 XTX に 64 GB の RAM を足すものです。RTX 4060 Ti のような小型カードでは、SSD からストリームし続けるのではなく、メモリに収まる Qwen UD-IQ2_XS ビルドを選ぶのが合理的です。