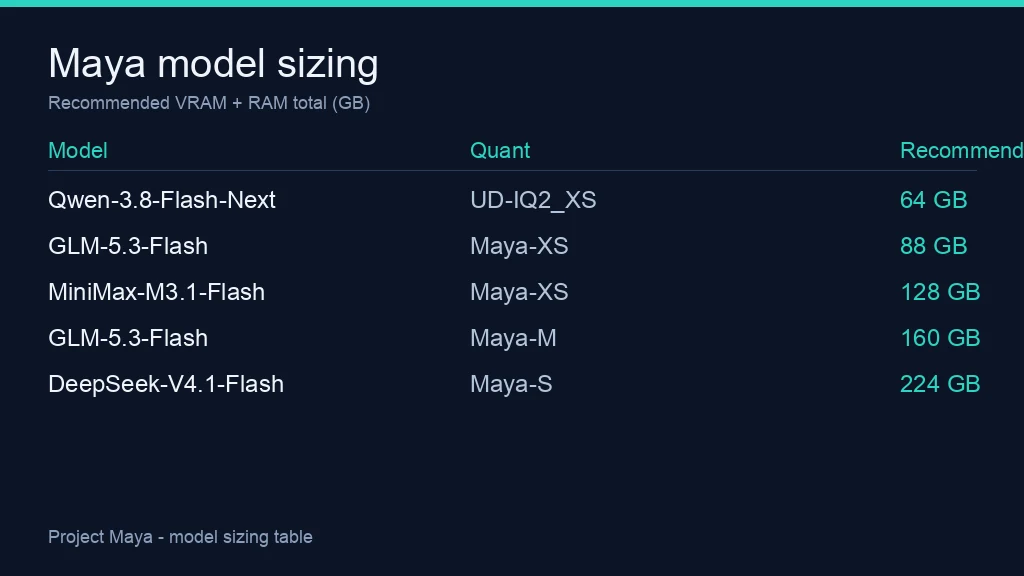
模型在你电脑上有多大,只由一个数字决定:显存加内存。Maya 把最常用的部分放在显卡上,其余放进系统内存,放不下的部分在生成回答时从 NVMe 固态硬盘读取。
两个尺寸要分清楚。*整模*是让模型全部常驻显存加内存所需的容量;*推荐值*则额外为系统和默认上下文留出余量。低于推荐值模型照样能跑,只是更慢,因为缺的部分要从硬盘流式读取。
显存加内存对照表
单位为 GB。整模是模型全部放进内存所需容量,推荐值为系统与默认上下文留出余量。
| 模型 | 量化 | 整模 | 推荐值(显存 + 内存) | 可运行设备 |
|---|---|---|---|---|
| GLM-5.3-Flash | Maya-XS | 约 80 | 88 | NVIDIA、AMD、Mac* |
| GLM-5.3-Flash | Maya-S24 | 约 102 | 128 | NVIDIA、AMD、Mac* |
| GLM-5.3-Flash | Maya-S(默认) | 约 104 | 128 | NVIDIA、AMD、Mac* |
| GLM-5.3-Flash | Maya-M | 约 124 | 160 | NVIDIA、AMD、Mac* |
| GLM-5.3-Flash | Maya-L | 约 164 | 192 | NVIDIA、AMD、Mac* |
| DeepSeek-V4.1-Flash | Maya-XS | 121 | 128 | NVIDIA、AMD |
| DeepSeek-V4.1-Flash | Maya-S(默认) | 186 | 224 | NVIDIA、AMD |
| DeepSeek-V4.1-Flash | UD-IQ1_M | 140 | 160 | NVIDIA、AMD |
| MiniMax-M3.1-Flash | Maya-XS | 100 | 128 | NVIDIA、AMD |
| MiniMax-M3.1-Flash | Maya-S | 130 | 160 | NVIDIA、AMD |
| Qwen-3.8-Flash-Next | UD-IQ2_XS | 47 | 64 | NVIDIA、AMD |
| Qwen-3.8-Flash-Next | CYBER-FROST Q5_K_M | 84 | 96 | NVIDIA、AMD |
\* Mac(Apple 芯片)支持仍属实验性,且只覆盖 GLM-5.3-Flash 的 GGUF 量化版本。DeepSeek 与 Qwen 附带的 n-gram 词表始终留在固态硬盘上,不计入内存,所以下载体积比表里看到的更大。
按自己那台机器对号入座
| 你的电脑 | 总内存 | 能完整装下 | 还能跑,但更慢 |
|---|---|---|---|
| 16 GB 显卡 + 48 GB 内存 | 64 | Qwen UD-IQ2_XS | GLM Maya-XS、GLM Maya-S24 |
| 24 GB 显卡 + 64 GB 内存 | 88 | GLM Maya-XS、Qwen UD-IQ2_XS | GLM Maya-S24、Qwen CYBER-FROST |
| 32 GB 显卡 + 96 GB 内存 | 128 | GLM Maya-S、GLM Maya-S24、MiniMax Maya-XS | GLM Maya-M |
| 48 GB 显卡 + 128 GB 内存 | 176 | GLM Maya-M、MiniMax Maya-S | GLM Maya-L、DeepSeek Maya-S |
| 64 GB 显卡 + 128 GB 内存 | 192 | GLM Maya-L | DeepSeek Maya-S |
| 64 GB 显卡 + 192 GB 内存 | 256 以上 | DeepSeek Maya-S、MiniMax EXL3 | DeepSeek UD-IQ3_S |
| 384 GB 内存的服务器 | 384 以上 | 全部模型,含 DeepSeek UD-Q8_K_XL | — |
共享内存的机器(Strix Halo、Gorgon Halo 或 Mac)只算一次总量,并给系统留出约 16 GB。独立显卡则更要看清分配:同样的总容量,放在显存里的部分越多,速度越快。
底线
只要机器有受支持的显卡、32 GB 内存,以及能放下下载体积的高速 NVMe 固态硬盘,低于推荐值模型也能运行。机械硬盘不行。
放不进显存加内存的部分会在生成时从硬盘读取。可以跑,但离推荐值越远越慢。安装程序会直接报出你这台电脑能常驻多少模型内存,所以在下几百 GB 的下载之前,先看清这个数字。
表格低端那一档,经典的「跑一个大模型」配置是 RTX 4090 或 RX 7900 XTX 配 64 GB 内存;像 RTX 4060 Ti 这样的小卡,更适合配能完整装进内存的 Qwen UD-IQ2_XS 版本,而不是让它一直从硬盘流式读取。